1. なぜ「高性能なLLM」を選んでも業務判断は間違えるのか?
業務プロセスとAIが相互に学習し続ける「自律型好循環モデル」を構築すれば、企業の意思決定は劇的に加速します。自律的にこのフライホイールを回転させることで実務を正しく機能させ、信頼に足る判断を引き出すことができます。しかし、どれほど力強く回転するフライホイールを手に入れても、それが誤った前提で動き出せば経営に危険をもたらします。 これを阻止するには、「業務に関するコンテキストを規定し、出力の信頼性を担保するアーキテクチャ」の設計が必須となります。
現在、多くの企業が「どの生成AI(LLM)を導入すべきか」「どうプロンプトを工夫するか」という領域に膨大な時間と予算を投じています。しかし、本番環境(プロダクション)でAIを業務判断に使うという観点から見れば、LLMのモデル本体はあくまで中心の「コア」にすぎず、成否に占める割合は全体のわずか10%です。
残りの90%は、中心にあるコアを包み込み、ビジネスの文脈と信頼性を与えるための「多重のアーキテクチャ(多層構造)」が担います。
「見た目だけはもっともらしい誤答」が経営を誤らせる
どれほど高出力なコア(LLM)を用意しても、適切な制御や検証の仕組みがなければ意図通りに答えを得ることはできません。この90%の多層構造を欠いたまま、高性能なLLMに社内データベースを直接つなぐと何が起きるでしょうか。
たとえば、データベース上に `revenue(売上)` という項目があるとします。生データの構造(スキーマ)からは、その列が「売上」であることまでは読み取れます。しかし、その数字が「受注ベースか売上計上ベースか」「グロス(総額)かネット(純額)か」「返品や値引きをどう扱うか」といった組織固有の定義は、生データそのものには書かれていません。
結果としてAIは、誤った前提のまま計算を行い、見た目だけは極めて流暢で説得力のある表現であっても、その実態は「もっともらしい嘘(誤った分析結果)」を堂々と返してしまいます。
意思決定層や顧客が得るのは「AIが出した洗練された回答」だけであり、その裏にある誤った前提条件には気づけません。AIが経営判断や対外的な業務のインターフェースになる時代において、これは単なるシステムエラーではなく、企業の信頼と意思決定そのものを揺るがす重大なリスクと言えます。
2. コア(10%)を包み込む「残り90%の多層構造」とは?
AIの推論能力(10%)を現実のビジネスで安全に機能させるためには、中心の核であるLLM(コア)を何重にも包み込み、業務に関するコンテキストを規定して出力の信頼性を担保する「残り90%の多層アーキテクチャ」が不可欠です。
実際、グローバルのAIエンジニアリングの最前線でも、モデル本体(コア)は一切変更せず、周囲を取り巻く多層構造(業務コンテキストの定義、ツール連携、制御・検証の仕組み)を整備しただけで、複雑なタスクのベンチマーク性能が圏外から上位へと向上した事例が報告されています。
「材料を渡す」だけでは不十分である理由
これまで、AIの誤答(ハルシネーション)を防ぐ対策としては、主に「インプット(入力)の改善」が語られてきました。社内文書を検索させるRAG(検索拡張生成)や、データ構造を伝えるグラウンディングによって、AIに正しい材料を渡そうというアプローチです。
しかし、本番環境で経営数値や業務判断を扱う場合、それだけでは決定的な問いが残ります。
「AIが導き出したその分析結果は、自社のビジネスルールに照らして本当に正しいと保証できるのか?」
インプットを改善し「AIが正しい答えに辿り着く確率を高める」ことと、コア全体を強固な多層アーキテクチャで包み込み「企業の基準に沿った信頼できる答えしか出さない仕組みをつくる」ことはまったく別の問題です。
3. コアと外周3層からなる「4層の同心円アーキテクチャ」
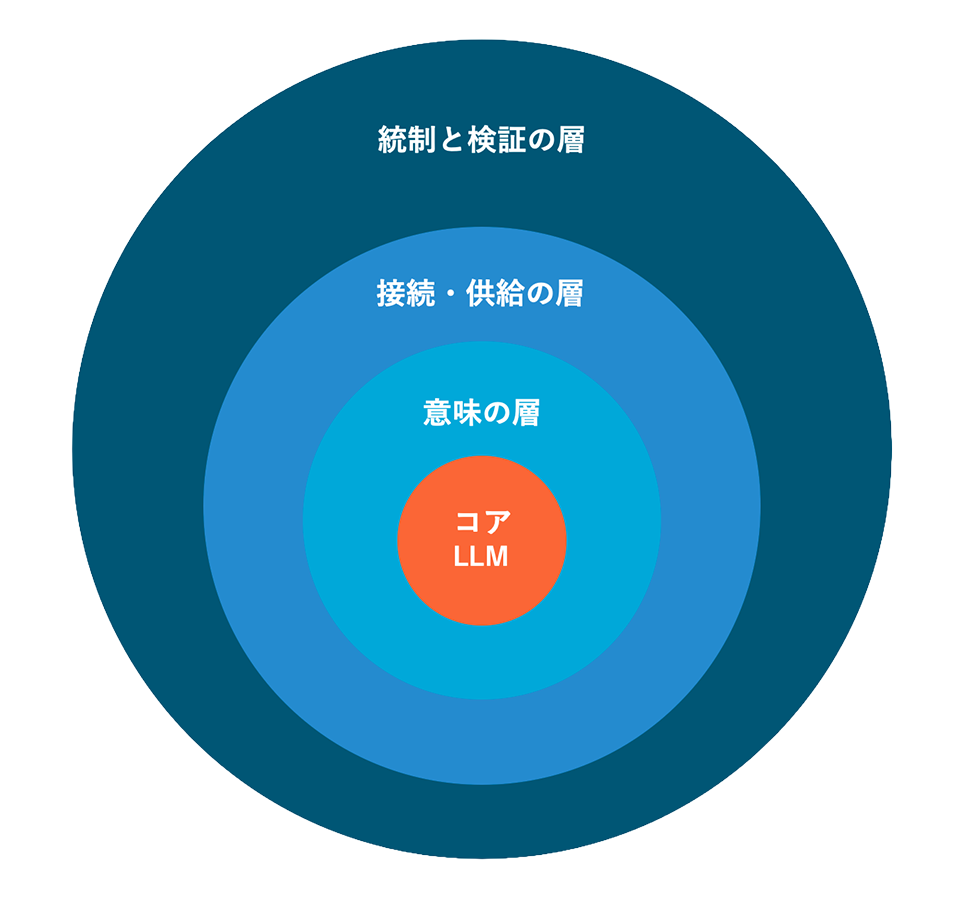
中心のLLM(コア・10%)を、経営判断を支える信頼性の高いシステムへと実装するためには、中心のコア層から外側に向かって広がる「4層の同心円アーキテクチャ(コア10%+外周3層90%)」を統合して設計する必要があります。
コア層(中心核・10%):推論・言語処理の層(LLM本体)── 思考と生成を担う
アーキテクチャの中心に位置するのが、LLM本体からなる「コア層」です。
自然言語の理解、文脈の推論、文章やコードの生成といった知的な処理を担いますが、この層単体では自社固有のビジネスルールやデータの前提条件を持ちません。そのため、外側を取り囲む3つの層(残り90%)によって定義・統制されることで初めて本番業務で機能します。
第1層(内側の輪):意味定義の層(セマンティック・レイヤー)── 業務コンテキストを規定する
中心にあるコア(LLM)のすぐ外側を取り囲むのが、「業務に関するコンテキストを規定する層」です。
組織固有のKPI定義、指標間の計算ロジック、データ同士の関係性、そして業務上の前提条件をセマンティック層として構造化し、コアが参照するルールを固定します。これにより、AIに勝手な推測をさせることなく、「経営会議のBIダッシュボードで見る売上」と「現場がAIに質問して返ってくる売上」が常に完全に一致する状態を担保します。
第2層(中間の輪):接続・供給の層(モデリング&デリバリー)── あらゆる接点へ一貫したロジックを供給する
意味定義によって規定された分析ロジックを、現場のあらゆる業務接点へと供給するのが中間の層です。
今後、社員や顧客が業務データへ問いかける窓口は、特定のBIツールの画面内だけにとどまりません。日常的に使う社内業務アプリケーションへの組み込み(SDK/API)はもちろん、外部の自律型AIエージェントが標準プロトコル(MCP:Model Context Protocol等)を通じて社内データ基盤へ直接アクセスし、自律的にタスクを遂行するケースが急速に広がっていきます。
この接続・供給のインターフェースを中央に集約することで、どのアプリや外部エージェントから問い合わせが飛んできたとしても、常に第1層で定義された公式の業務ロジックを通過した回答だけを供給できるようになります。
第3層(最外周の輪):統制と検証の層(ガバメント・プラットフォーム)── 出力の信頼性と安全性を担保する
そして、これらすべての構造を最外周から360度取り囲み、「出力の信頼性とセキュリティを担保する層」が第3層です。
どれほど計算ロジックが正しくても、「本来その情報を見る権限のないユーザー」に機密データや他部門の数値を含んだ回答を返してしまえば、重大なセキュリティ事故となります。
最外周のレイヤーでは、認証・SSO(シングルサインオン)、マルチテナント分離、そして従来の基幹システムやBI基盤で厳格に運用してきた「行レベル・列レベルセキュリティ」や権限管理をそのまま継承します。「このユーザーはどのデータにアクセスしてよいのか」という権限の枠組みの中でコアを稼働させ、さらに組織で承認・検証済みの分析ロジックを基準として出力を照合することで、あらゆる接点からの利用に対して揺るぎない安全と信頼を担保します。
4. 既存のデータ・BI資産は「AIの判断を律する業務コンテキスト・検証基準」になる
生成AIの登場によって、「これまでのBIダッシュボードやデータウェアハウス(DWH)への投資は役割を終えるのではないか」という議論が聞かれることがあります。
しかし、現実はまったく逆です。
これまで企業が時間とコストをかけて整備してきたデータ基盤、KPIの定義、セキュリティルール、そして承認済みのダッシュボード群は、決して過去の遺物ではありません。それらはすべて、中心にあるコア(10%)を取り囲み、自社のビジネスルール通りに振る舞わせるため、残り90%を占める「多層アーキテクチャ(業務コンテキストと検証基準)」の中核として機能します。
AI Driven 経営を真に実現するためには、以下の2つの設計思想が両輪として噛み合う必要があります。
・業務プロセスとAIが相互に学習・進化する「自律型好循環モデル」の構築
・中心のコア(10%)を3層の同心円で取り囲み、業務に関するコンテキストを規定して出力の信頼性を担保する「4層の同心円アーキテクチャ(90%)」の確立
そして、これらの強固なアーキテクチャ(業務コンテキストと検証基準)の上で、最終的にAIの回答の妥当性を見極め、経営としての意思決定と責任を引き受けるのは、他ならぬ人間です。システムがどれほど精緻な構造と検証基準を備えていても、監督し判断を下す主体が人間であることは変わりません。
これまで積み上げてきたデータ活用基盤やBIの資産を、AIの判断を律する「業務コンテキストと検証基準」へと昇華させること。それこそが、一過性のAI導入を終わらせ、真のAI Driven 経営を実装するための鍵となります。
キーワード
注目の記事一覧
-
 AI導入の成否は「モデル選定」ではなく「業務コンテキスト」で決まる
-
 AI Driven 経営を実現する「自律型好循環モデル」とは?
-
 業務判断を下せるAIへ:Clean Coreで挑む「3つのデータモデル」統合
-
 AIエージェント開発・運用における可観測性
-
 AIエージェントの開発入門
月別記事一覧
- 2026年11月 (1)
- 2026年10月 (1)
- 2026年9月 (1)
- 2026年8月 (1)
- 2026年7月 (1)
- 2026年6月 (1)
- 2026年5月 (1)
- 2026年4月 (1)
- 2026年3月 (1)
- 2026年2月 (1)
- 2026年1月 (1)
- 2025年12月 (1)